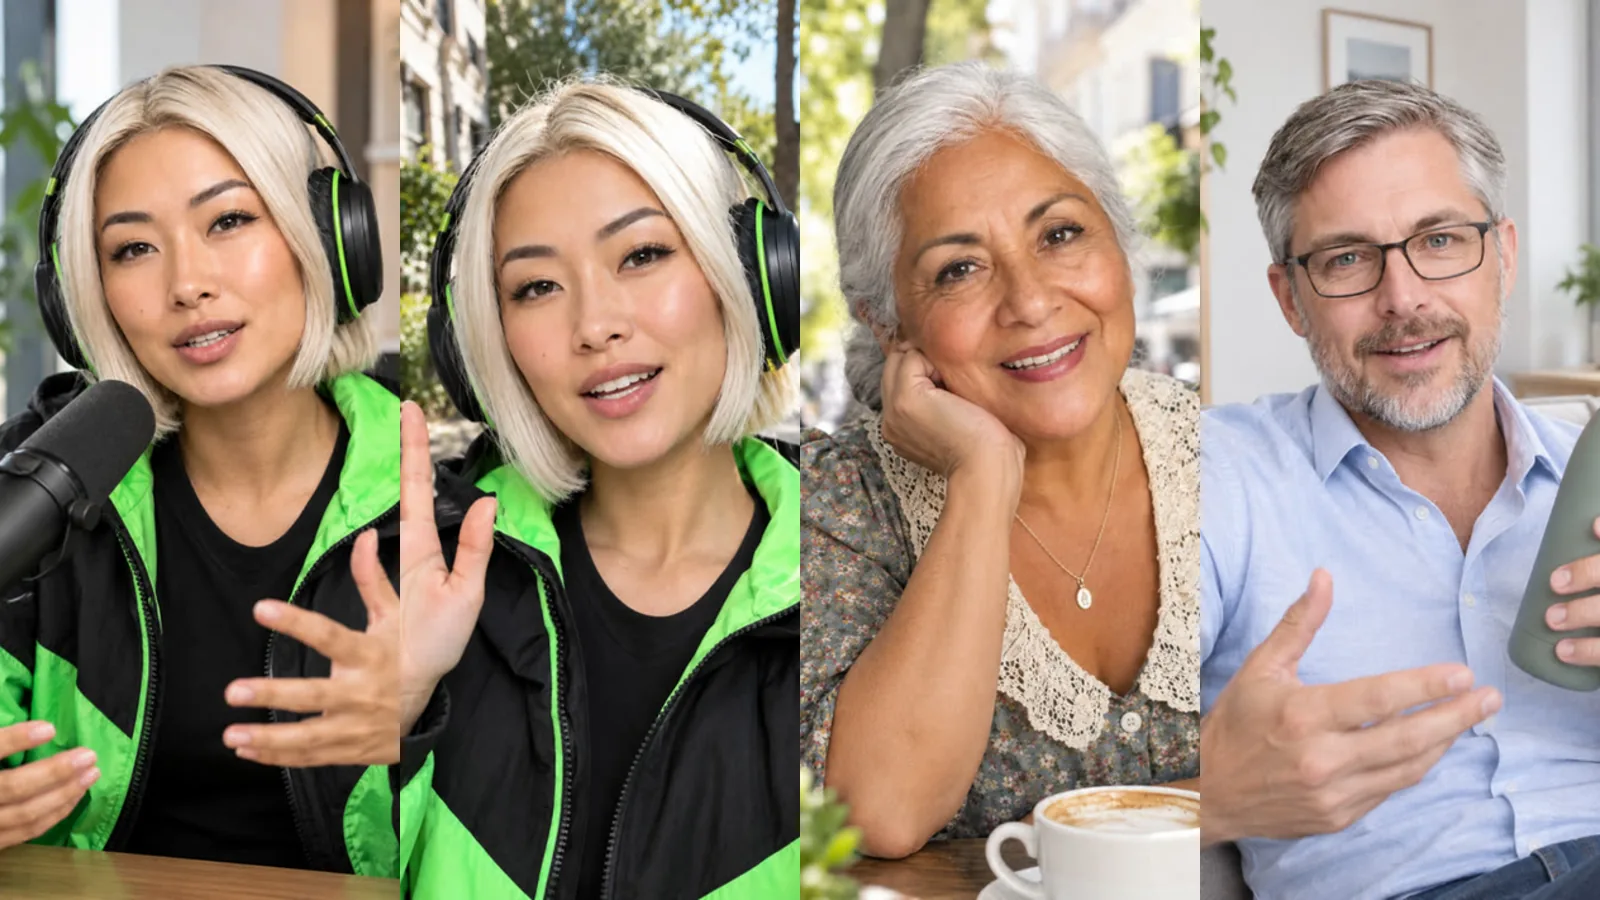
İnsanlar başka herhangi bir şeyde uzmanlaşmadan çok önce yüzlerde uzmanlaşır. Farkında olmadan dudak okuruz ve ağız ile ses uyuşmadığında bunu saniyenin küçük bir kesrinde fark ederiz. Konuşan video bu yüzden yapay zekâ videosunun en zor sorunlarından biridir ve küçük teknik tercihler büyük fark yaratır. Bu makale dudak senkronunun neyi doğru yapması gerektiğini ve AI Influencer Studio'daki konuşan videonun soruna nasıl yaklaştığını anlatıyor.
Sesler ve ağız biçimleri birebir eşleşmez
Konuşma seslerden (fonemlerden) oluşur; görünen ağız konumlarına ise vizem denir. Birçok ses aynı vizemi paylaşır: p, b ve m'nin hepsinde dudaklar kapanır. Bazı farklar ise hiç görünmez: k ve g ağzın arka kısmında oluşur. Bir dudak senkronu sistemi harf başına bir biçim değil, sese uygun doğru ağız biçimleri dizisini üretmelidir.
Gerçek ağızlar bir sonraki sesi de önceden hazırlar. "Su" kelimesinde dudaklar, s sesi daha bitmeden u için yuvarlanmaya başlar. Koartikülasyon denen bu örtüşme, konuşmanın neden akıcı göründüğünü ve tek tek her biçim doğru olsa bile biçimden biçime atlayan bir ağzın neden robot gibi göründüğünü açıklar.
Zamanlama toleransı dardır
İzleyiciler görüntünün biraz gerisinde kalan sesi, önüne geçen sese göre daha kolay tolere eder; ama pencere dardır, kabaca birkaç video karesi. Bu pencerenin içinde kalan hatalar fark edilmez; uzun bir cümle boyunca biriken hatalar ise göze batar. Uzun konuşmanın tek parça halinde değil, daha kısa kliplere bölünerek üretilmesinin bir nedeni de budur.
Yüzün görünmesi gerekir
Dudak senkronunun üzerinde çalışabileceği bir ağza ihtiyacı vardır. Geniş planda küçük bir yüz, belirgin bir profil, ağzın önünde bir el ya da fincan veya hızlı baş hareketi iyi sonuç ihtimalini düşürür. Konuşmak için hazırlanmış, yüzün büyük ve kameraya dönük olduğu sahneler tutarlı biçimde daha iyi görünür. Hiç yüz bulunamadığında zorlamak yerine seslendirmeye geçmek daha iyidir; dudak senkronu bedeli de iade edilmelidir.
Dil önemlidir
Diller konuşma hızı, ritim ve tipik ağız biçimleri bakımından farklıdır. Aynı uzunluktaki bir cümle Türkçe, Almanca ya da İtalyancada farklı sürer; bu yüzden konuşan bir klibin süresi sabit bir hızla değil, metinden ve dilden hesaplanır. Tek bir replikte dilleri karıştırmak hem telaffuzu hem ağız hareketini daha az güvenilir kılar.
İki yaklaşım: önce ses ya da önce video
Önce ses: sesi metinden üretin, sonra bir yüzü bu sese uyacak şekilde canlandırın. Ses tam istendiği gibidir ve metin birebir yazılan metindir. Zayıf noktası yüzdür: var olan bir portreyi sabit bir ses kaydına göre canlandırmak ağzı çoğu zaman iyi oynatır, ama yüzün geri kalanını, başı ve bedeni daha az doğal hareket ettirir.
Önce video: karakteri konuşurken, sesiyle birlikte tek geçişte üretin. Ağız, yüz, nefes ve jestler birbirine ait olduğu için daha doğal görünür. Zayıf noktası kontroldür: ses karakterinizin sesi değildir ve kelimeler metninizden biraz farklı olabilir.
Yüksek kaliteli konuşan video iki yaklaşımın güçlü yanlarını birleştirir. Klip önce video yöntemiyle üretilir, böylece hareket doğaldır. Ardından konuşma, zamanlaması korunarak karakterin kayıtlı sesine çevrilir; böylece ağız yine uyar. Son olarak söylenen kelimeler yazıya dökülür ve metinle karşılaştırılır; metni yeterince yakın söylemeyen bir klip yeniden üretilir, bu da olmazsa video yedek olarak önce ses yöntemiyle tamamlanır ve fiyat farkı iade edilir. Kullanıcı tarafı konuşan video rehberinde anlatılıyor.
Bir konuşan video nasıl değerlendirilir
- Kapanmalar: p, b ve m'de dudaklar tam kapanıyor mu?
- Zamanlama: kaymanın ilk görüldüğü yer olan her cümlenin ilk ve son kelimelerine bakın.
- Yüzün tamamı: gözler, yanaklar ve baş konuşmayla birlikte hareket ediyor mu, yoksa yalnız ağız mı?
- Geçişler: uzun videolarda klip geçişleri görüntüde ve seste pürüzsüz mü?
- Doğruluk: video tam olarak sizin metninizi, adları doğru telaffuz ederek söylüyor mu?
- Ses: ilk klipten son klibe aynı ses mi?
Kaliteyi hâlâ sınırlayanlar
Çok uzun tek cümleler, hızlı konuşma, şarkı söyleme, güçlü duygusal bağırmalar ve kamerada aynı anda konuşan birden fazla kişi hâlâ zor. Kare videolar ve sahnelerdeki daha uzun replikler yüksek kaliteli yöntem yerine standart dudak senkronu kullanır. Kaliteyi artıran her denetim süreyi de uzatır: konuşan bir klibin hazırlanması yaklaşık iki dakika sürer.
Sık sorulanlar
Neden var olan herhangi bir videoya dudak senkronu uygulanmıyor? Var olan bir klipte dudak senkronu yalnız ağzı değiştirir. Yüzün geri kalanı konuşmayla birlikte hareket etmiyorsa sonuç dublaj gibi görünür. Klibi baştan konuşma olarak üretmek daha doğal bir yüz verir.
Konuşan klipler neden en çok sekiz saniye? Kısa klipler zamanlamayı ve kimliği daha sıkı tutar. Uzun metin cümle sınırlarından bölünür ve kısa, yumuşak geçişlerle birleştirilir.
Karakterin kendi sesi bu süreçte korunuyor mu? Evet. Karakterle birlikte kaydedilen ses, ister ses kütüphanesinden ister klonladığınız kendi sesiniz olsun, her klipte duyduğunuz sestir.