Un influencer IA coherente es un personaje que se reconoce en muchas imágenes y vídeos creados en momentos distintos. La coherencia no es una propiedad de un solo modelo; nace de cómo se organiza la producción. Este artículo describe las piezas, cómo las usa AI Influencer Studio y dónde están sus límites.
¿Qué es un set de referencia?
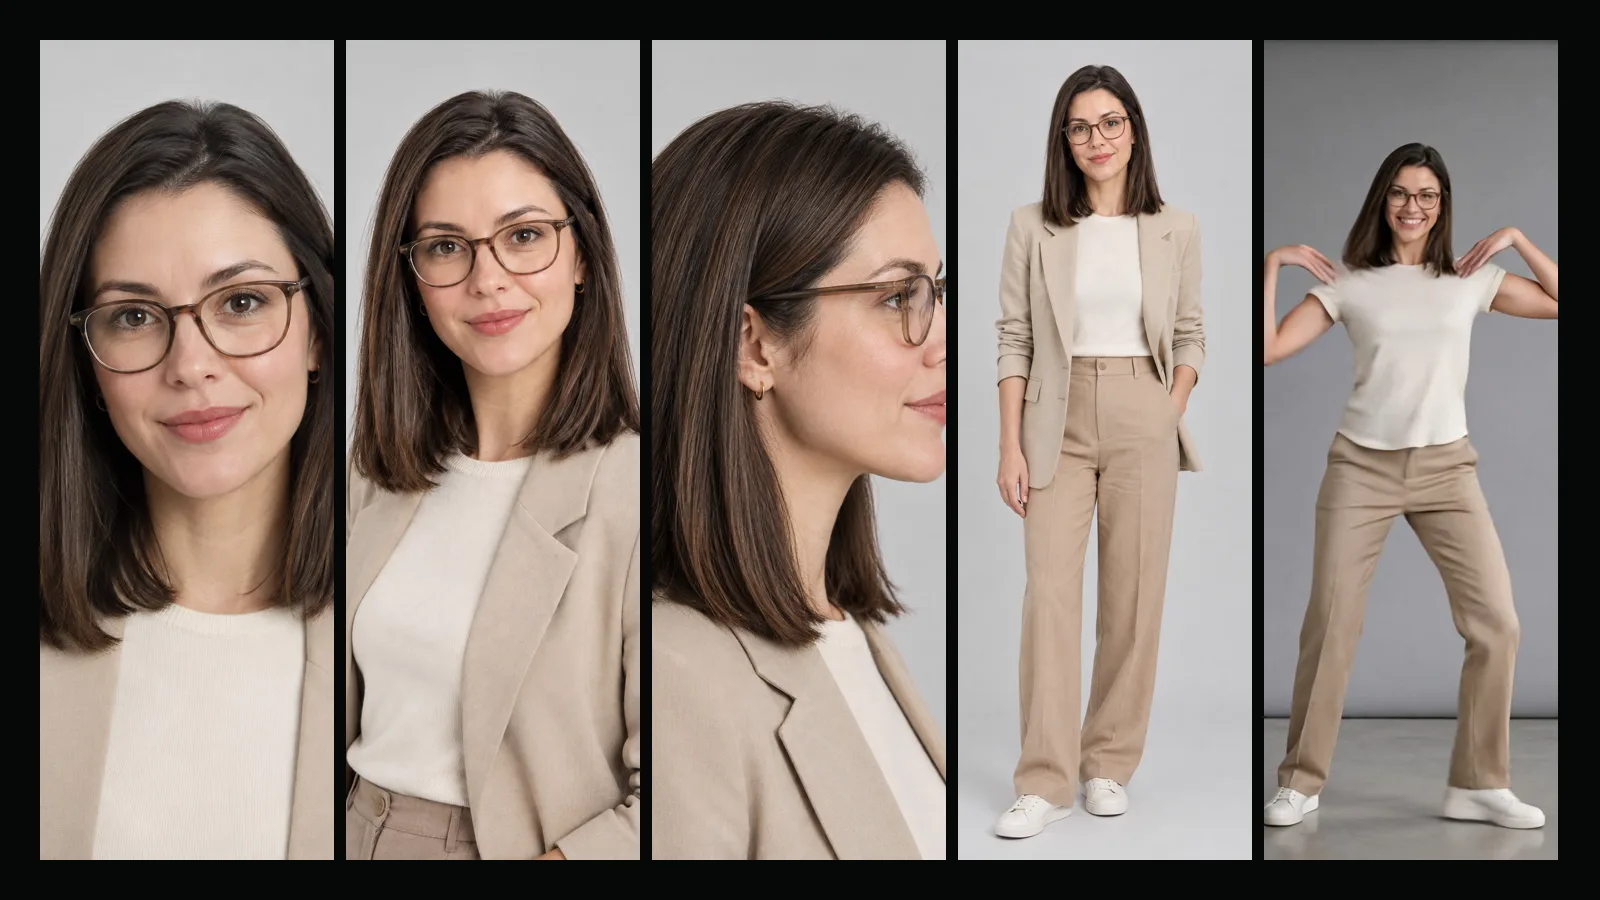
Un set de referencia es un pequeño grupo de imágenes del mismo personaje desde ángulos definidos. En el estudio tiene cuatro vistas fijas: un retrato frontal para la identidad, una vista de cuerpo entero para las proporciones y la ropa, una vista de tres cuartos y un perfil para la forma de la cara y el pelo. Cada imagen o vídeo posterior recibe parte de esas referencias, así que el generador copia un aspecto acordado en lugar de inventar uno nuevo.
El orden importa. Primero se crea el retrato; todas las demás vistas se crean a partir de él. Si el retrato salió de una foto real, la foto se usa una vez más como ancla de identidad y después nunca más.
¿Por qué un perfil estructurado?
El texto libre es ambiguo: «pelo oscuro» puede acabar negro o castaño, y los detalles cambian de un clip a otro. Un perfil estructurado convierte la descripción en elecciones fijas, como un peinado, un color de pelo o «gafas, a veces», más listas de prendas, lugares y colores de la paleta. En el estudio, Sam pasa un párrafo a esta estructura y solo rellena los campos que el texto respalda de verdad. Los campos vacíos no se adivinan; se deciden una vez, al crear el set de referencia, y desde entonces los llevan las referencias.
¿Qué aportan los atuendos y los lugares?
El reconocimiento no depende solo de la cara. La ropa y los lugares recurrentes funcionan como un departamento de vestuario y un decorado. El estudio guarda los looks del armario como variantes de atuendo del personaje y los lugares como imágenes de fondo vacías. Así, un vídeo puede referirse al «personaje» más «atuendo 2» más «el rincón de trabajo» y mantener tres cosas estables a la vez.
¿Dónde encaja la transferencia de movimiento?
Describir un baile con palabras rara vez da un baile creíble. La transferencia de movimiento lo resuelve de otra forma: toma el movimiento de un clip existente y lo aplica a una imagen fija del personaje. El estudio redibuja primero el primer fotograma del clip de origen con el personaje en la misma pose y encuadre, y después transfiere todo el movimiento a ese fotograma. El ritmo, los gestos y la sensación de cámara vienen del origen; la identidad, de las referencias.
¿Cuáles son los límites?
- Una persona por clip. Si el vídeo de origen muestra a varias, se sustituye a una.
- Los movimientos muy rápidos o poco habituales pueden desdibujar un instante las manos o la cara.
- Detalles pequeños como joyas o texto en la ropa pueden variar entre clips.
- Los vídeos hablados mantienen la cara del retrato; los giros grandes de cabeza no forman parte de ese formato.
Elegir el nivel Standard, dar referencias claras y usar imágenes sencillas de productos o ropa reduce la mayoría de estos efectos.
¿Qué tiene que ver la seguridad con la coherencia?
Un personaje que puede recrearse sin fin necesita reglas claras sobre qué cara lleva. El estudio solo permite una foto real con consentimiento, revisa cada foto y cada vídeo subido, limita los personajes a adultos y mantiene las fotos privadas. La guía de seguridad describe cada paso.
Preguntas frecuentes
¿Basta con una sola imagen de referencia? Una imagen conserva una cara, pero no las proporciones ni la parte de atrás de la cabeza. Varias vistas fijas dan resultados más estables; por eso el estudio crea siempre cuatro.
¿Una instrucción más larga hace más coherente al personaje? Por sí sola, no. Las referencias fijas y un perfil estructurado importan más que las descripciones largas, que se interpretan de forma distinta cada vez.
¿Se puede garantizar la coherencia? Ningún generador es perfectamente coherente, pero referencias, perfiles y transferencia de movimiento juntos mantienen a un personaje reconocible en muchos clips.