Un influencer IA coerente è un personaggio riconoscibile in molte immagini e video creati in momenti diversi. La coerenza non è la proprietà di un singolo modello; nasce da come è organizzata la produzione. Questo articolo descrive i mattoni, come li usa AI Influencer Studio e quali sono i loro limiti.
Che cos’è un set di riferimento?
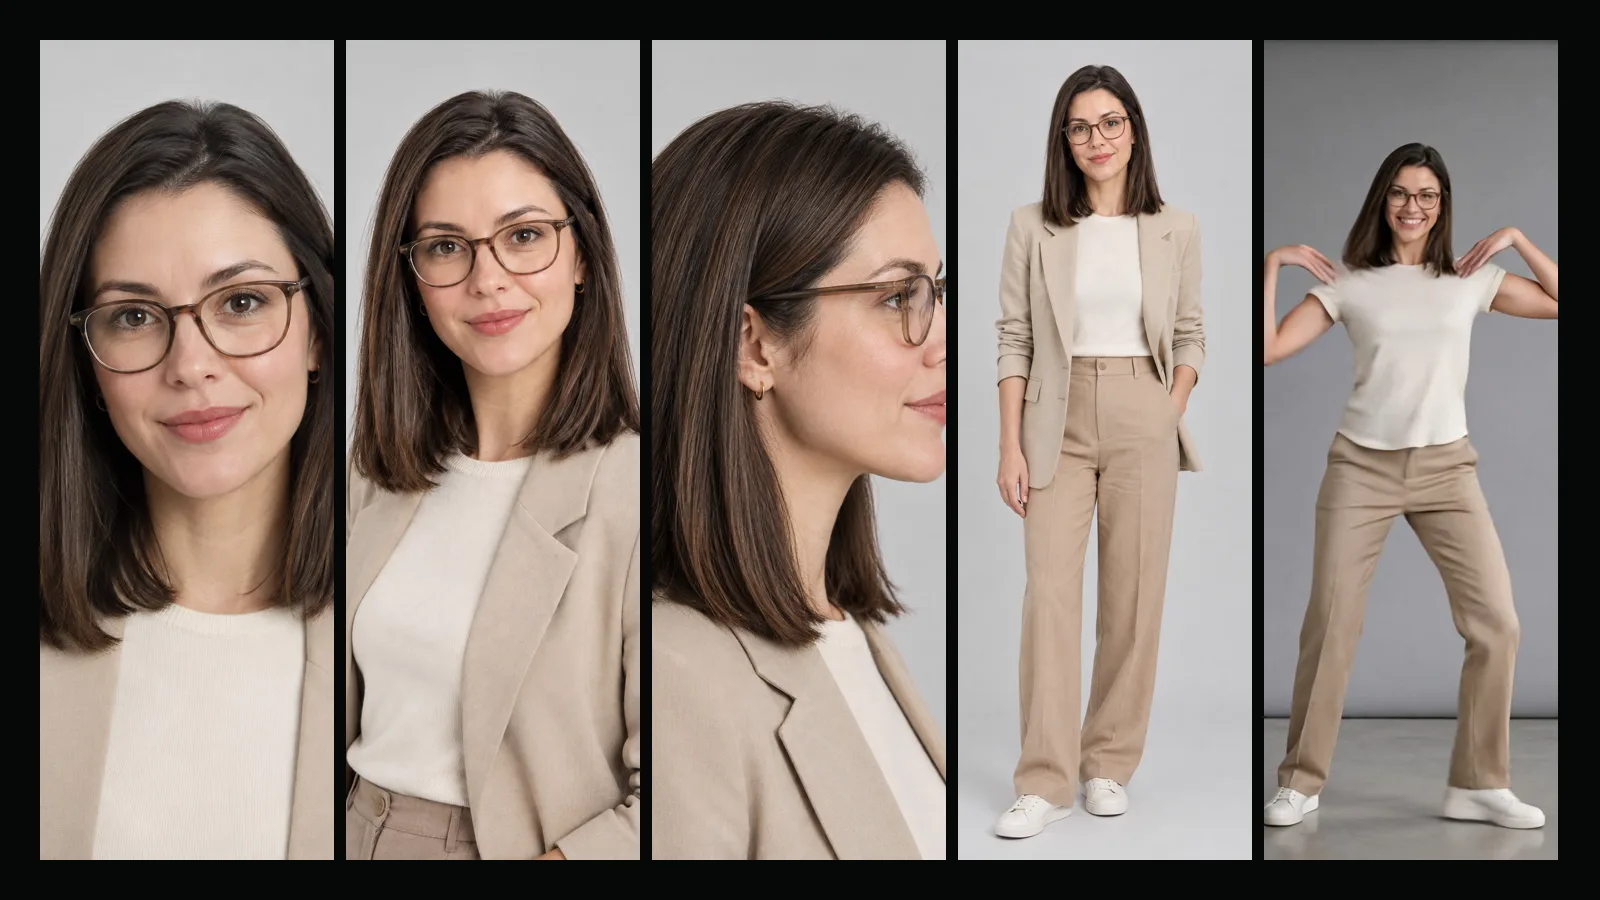
Un set di riferimento è un piccolo gruppo di immagini dello stesso personaggio da angolazioni definite. Nello studio ha quattro viste fisse: un ritratto frontale per l’identità, una vista a figura intera per proporzioni e vestiti, una vista di tre quarti e un profilo per la forma del viso e dei capelli. Ogni immagine o video successivo riceve parte di questi riferimenti, così il generatore copia un aspetto concordato invece di inventarne uno nuovo.
L’ordine conta. Prima viene creato il ritratto; tutte le altre viste nascono dal ritratto. Se il ritratto viene da una foto reale, la foto viene usata ancora una volta come ancora d’identità e poi mai più.
Perché un profilo strutturato?
Il testo libero è ambiguo: «capelli scuri» può diventare nero o castano, e i dettagli cambiano da una clip all’altra. Un profilo strutturato trasforma la descrizione in scelte fisse, come un’acconciatura, un colore dei capelli o «occhiali, a volte», più elenchi di capi, luoghi e colori della palette. Nello studio, Sam converte un paragrafo in questa struttura e compila solo i campi che il testo sostiene davvero. I campi vuoti non vengono indovinati; vengono decisi una volta, quando si crea il set di riferimento, e da lì in poi li portano i riferimenti.
Cosa aggiungono outfit e luoghi?
Il riconoscimento non dipende solo dal volto. Vestiti e luoghi ricorrenti funzionano come un reparto costumi e una scenografia. Lo studio salva i look come varianti di outfit del personaggio e i luoghi come immagini di sfondo vuote. Un video può così fare riferimento al «personaggio» più «outfit 2» più «l’angolo di lavoro», mantenendo stabili tre cose contemporaneamente.
Dove si inserisce il trasferimento del movimento?
Descrivere un ballo a parole raramente produce un ballo credibile. Il trasferimento del movimento risolve il problema in un altro modo: prende il movimento da una clip esistente e lo applica a un’immagine ferma del personaggio. Lo studio ridisegna prima il primo fotogramma della clip di partenza con il personaggio nella stessa posa e inquadratura, poi trasferisce tutto il movimento su quel fotogramma. Tempi, gesti e sensazione della camera vengono dalla fonte; l’identità dai riferimenti.
Quali sono i limiti?
- Una persona per clip. Se il video di partenza mostra più persone, ne viene sostituita una.
- Movimenti molto rapidi o insoliti possono sfocare per un attimo mani o volto.
- Piccoli dettagli come gioielli o scritte sui vestiti possono variare tra una clip e l’altra.
- I video parlati mantengono il volto del ritratto; le grandi rotazioni della testa non fanno parte di quel formato.
Scegliere il livello Standard, fornire riferimenti chiari e usare immagini semplici di prodotti o vestiti riduce la maggior parte di questi effetti.
Cosa c’entra la sicurezza con la coerenza?
Un personaggio che si può ricreare all’infinito ha bisogno di regole chiare su quale volto porta. Lo studio consente una foto reale solo con consenso, controlla ogni foto e ogni video caricato, limita i personaggi agli adulti e mantiene private le foto. La guida alla sicurezza descrive ogni passaggio.
Domande frequenti
Basta una sola immagine di riferimento? Un’immagine conserva un volto, ma non le proporzioni né la parte posteriore della testa. Più viste fisse rendono i risultati più stabili; per questo lo studio ne crea sempre quattro.
Un’istruzione più lunga rende il personaggio più coerente? Non da sola. Riferimenti fissi e un profilo strutturato contano più delle descrizioni lunghe, che vengono interpretate in modo diverso ogni volta.
La coerenza si può garantire? Nessun generatore è perfettamente coerente, ma riferimenti, profili e trasferimento del movimento insieme mantengono un personaggio riconoscibile in molte clip.